메트릭과 트레이스를 사용하여 메모리 누수 진단하기
오픈텔레메트리(OpenTelemetry)와 같은 도구가 제공하는 애플리케이션 텔레메트리는 분산 시스템의 문제를 진단하는 데 매우 유용하다. 이 시나리오에서는 상위 수준의 메트릭과 트레이스를 출발점으로 메모리 누수의 원인을 파악하는 과정을 살펴본다.
설정
이 시나리오를 실행하려면 데모 애플리케이션을 배포하고
recommendationCacheFailure 피처 플래그를 활성화해야 한다. 피처 플래그를
활성화한 뒤 데이터가 쌓이도록 애플리케이션을 약 10분 동안 실행한다.
진단
문제를 진단하는 첫 단계는 문제가 존재하는지 확인하는 것이다. 대개 그라파나(Grafana)와 같은 도구가 제공하는 메트릭 대시보드를 먼저 확인하게 된다.
데모를 실행하면 데모 대시보드 폴더에 두 개의 대시보드가 있어야 한다. 하나는 오픈텔레메트리 컬렉터를 모니터링하기 위한 것이고, 다른 하나에는 각 서비스의 지연 시간과 요청률을 분석하는 여러 쿼리와 차트가 있다.
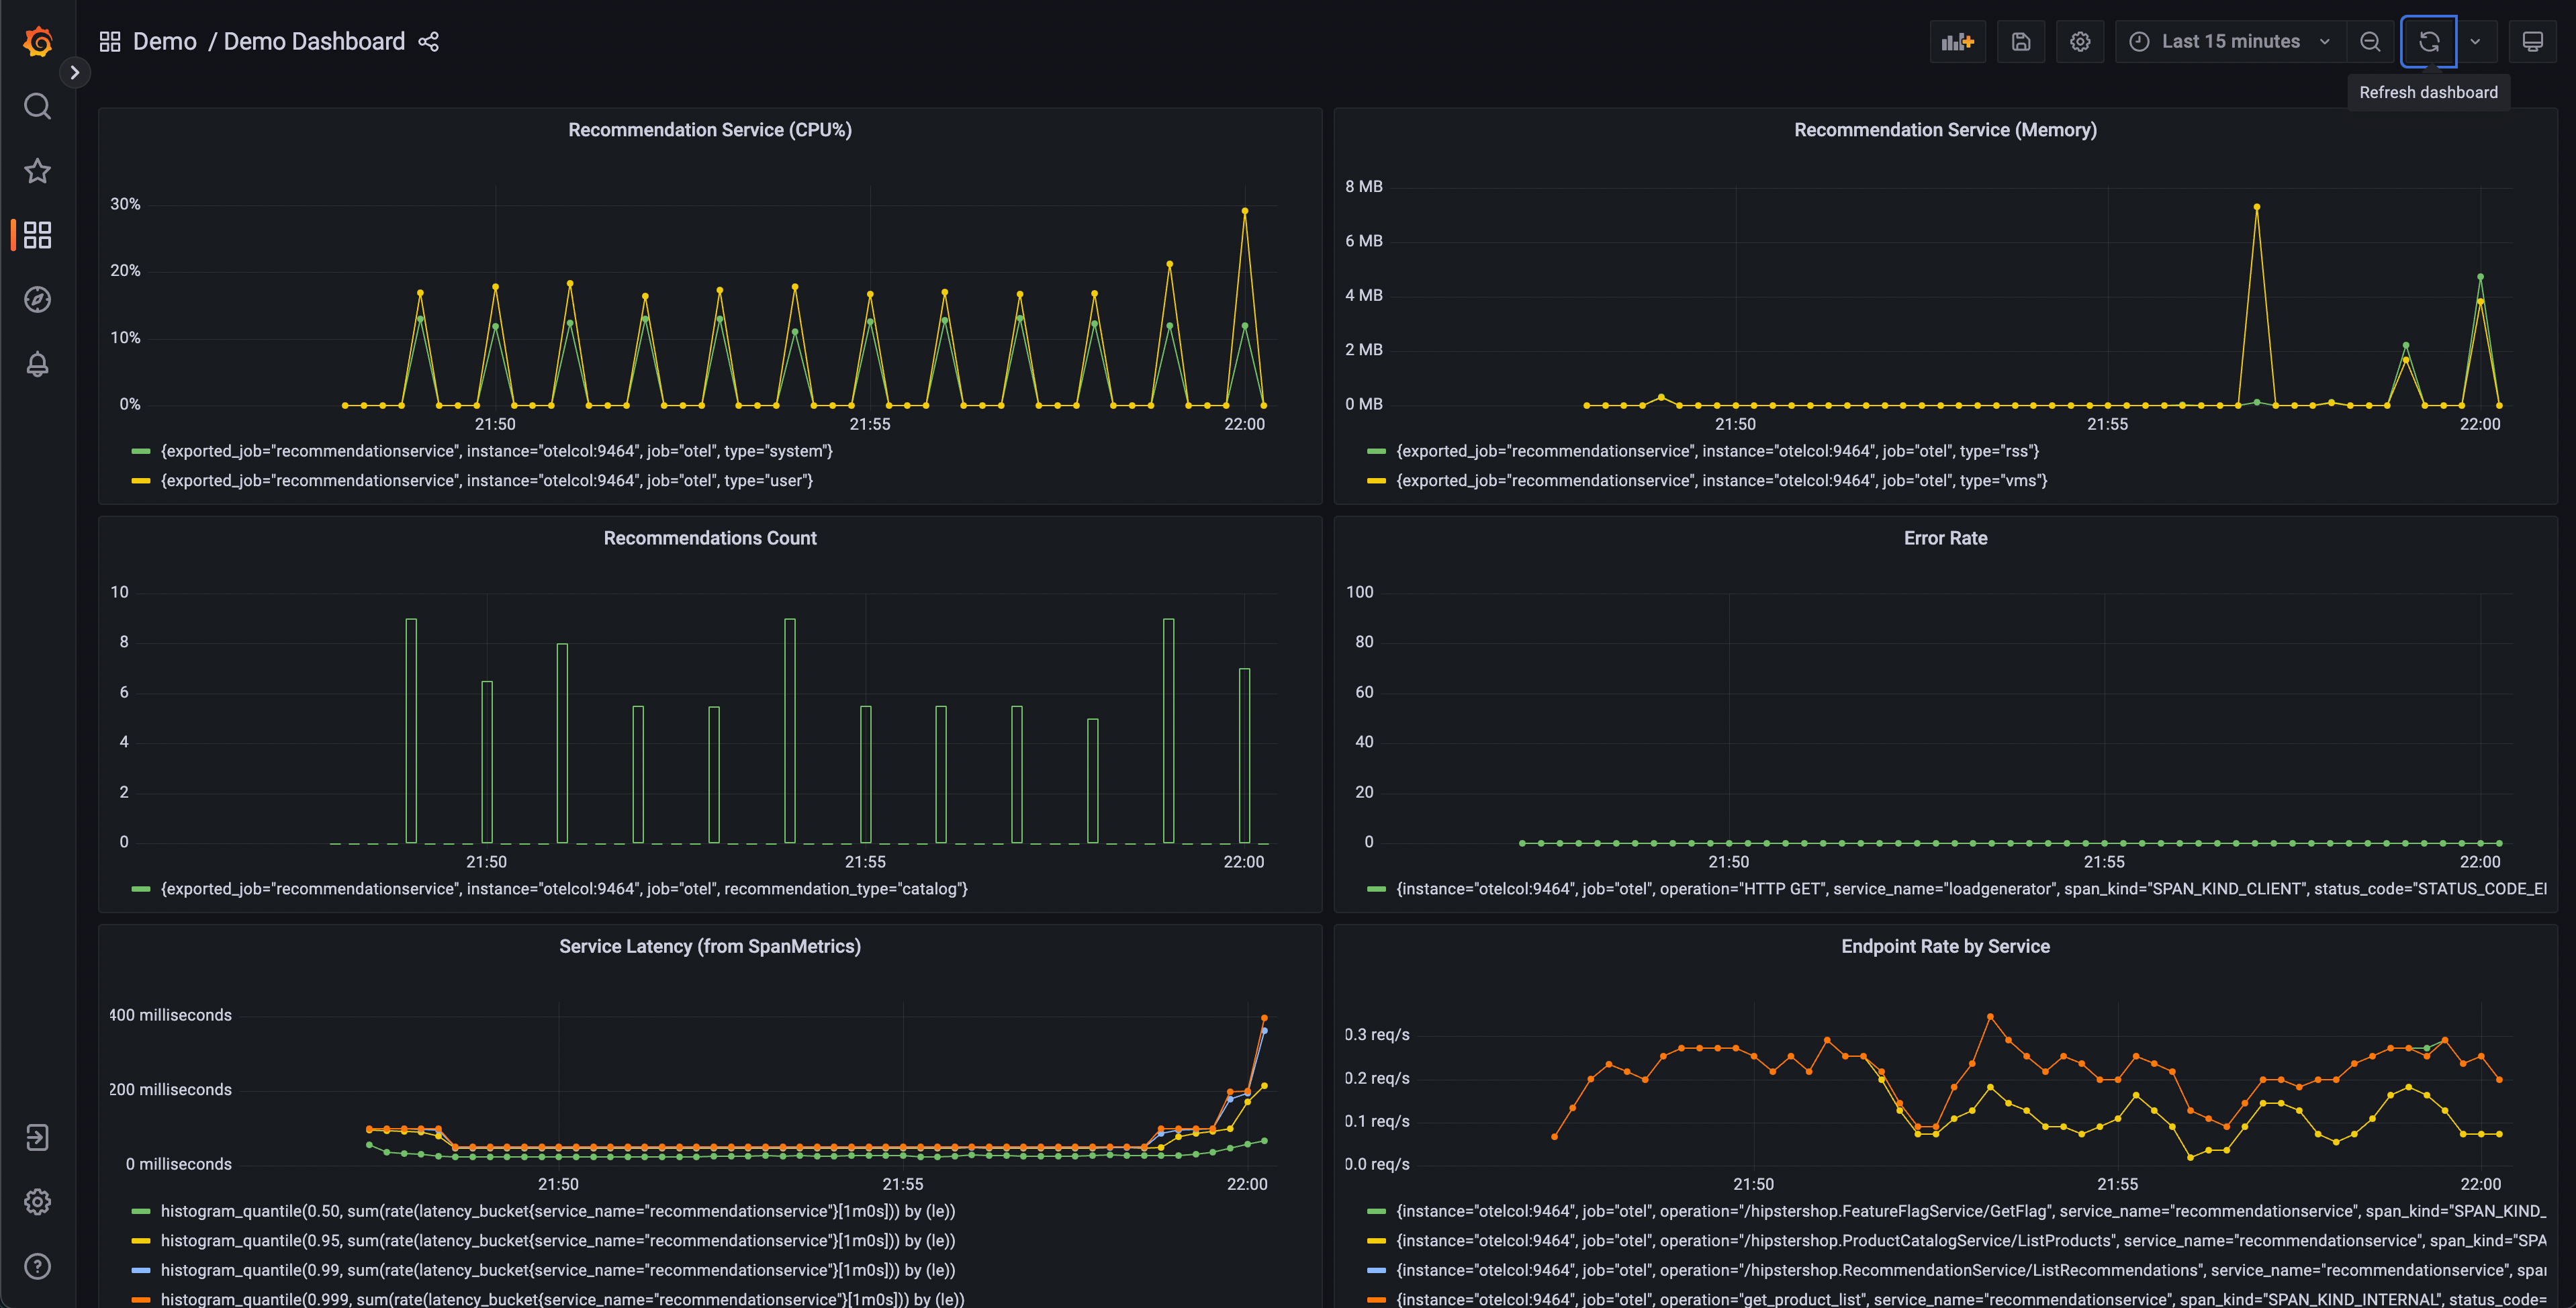
이 대시보드에는 여러 차트가 있지만, 다음 차트를 눈여겨볼 필요가 있다.
- 추천 서비스(CPU 사용률과 메모리)
- 서비스 지연 시간(SpanMetrics에서 생성)
- 오류율
추천 서비스 차트는 프로메테우스(Prometheus)로 내보낸 오픈텔레메트리 메트릭으로 생성되며, 서비스 지연 시간과 오류율 차트는 오픈텔레메트리 컬렉터의 스팬 메트릭 프로세서를 통해 생성된다.
대시보드를 보면 추천 서비스에서 비정상적인 동작이 나타나는 듯한 모습을 볼 수 있다. CPU 사용률이 급격히 치솟고, p95, p99, p99.9 히스토그램에서 긴 꼬리 지연 시간(tail latency)이 관찰된다. 이 서비스의 메모리 사용률도 간헐적으로 급격히 치솟는 것을 확인할 수 있다.
애플리케이션에서 트레이스 데이터도 내보내고 있으므로, 이를 활용해 문제가 있는지 확인하는 다른 방법을 살펴본다.
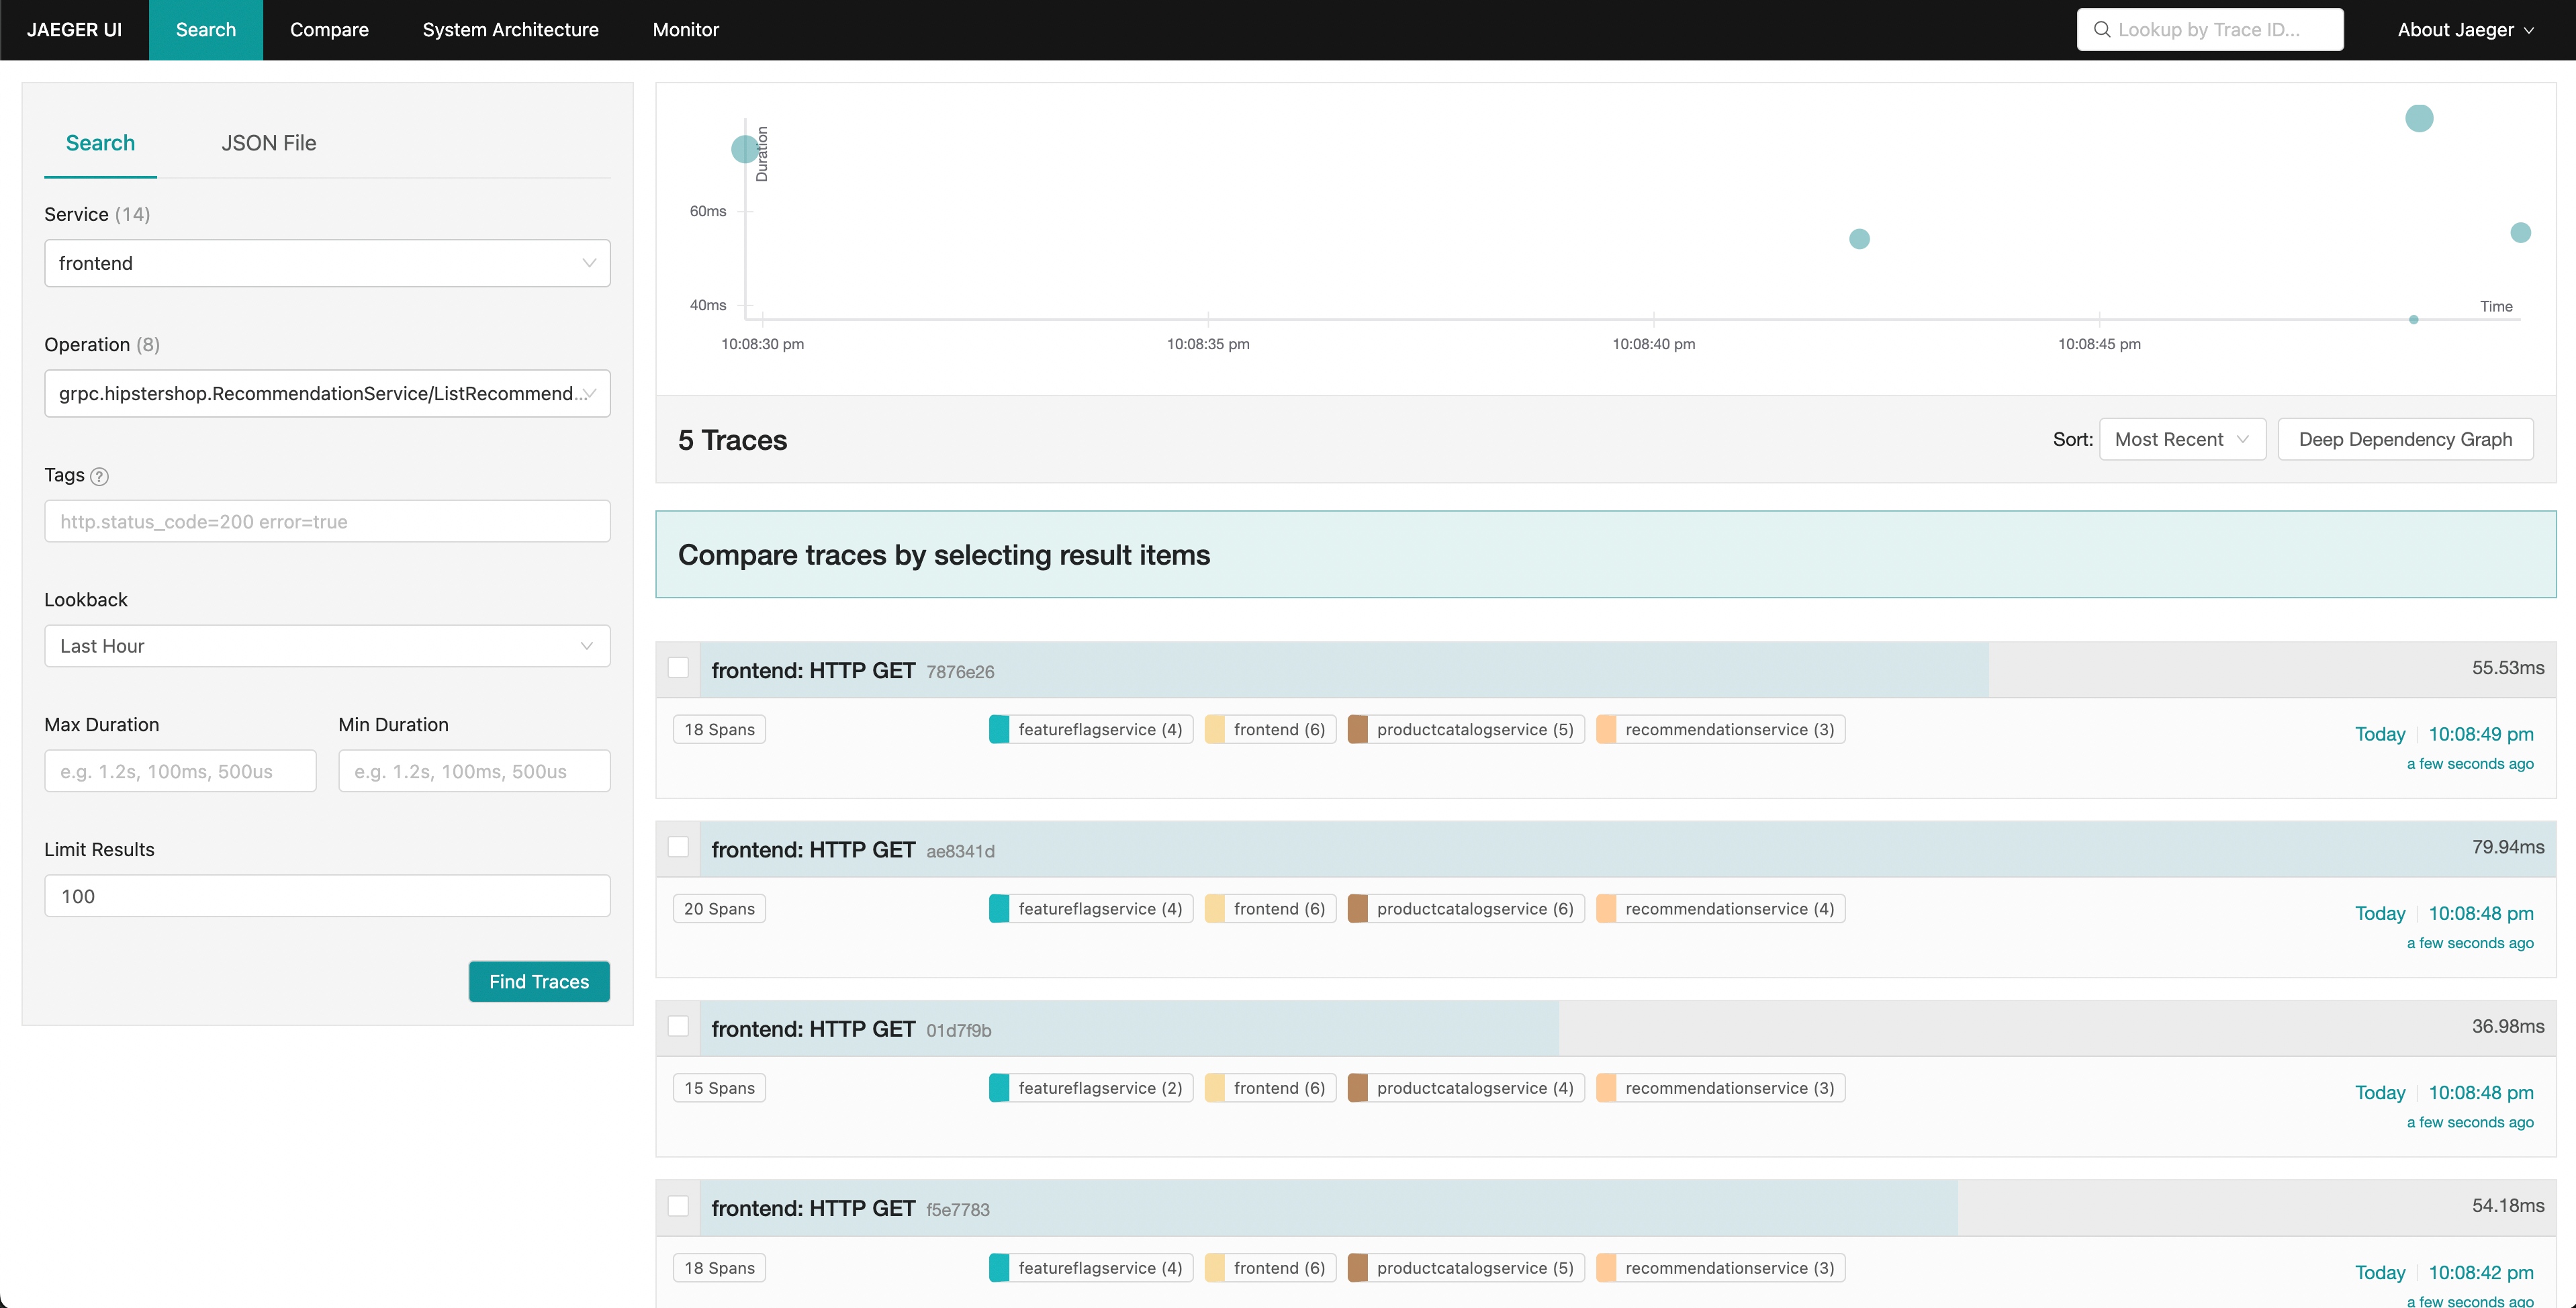
예거(Jaeger)를 사용하면 트레이스를 검색하고, 전체 요청을 구성하는 각 부분을 살펴보면서 요청 전체의 종단 간 지연 시간을 확인할 수 있다. 프론트엔드 요청의 꼬리 지연 시간이 증가한 것을 발견했다고 가정한다. 이때, 예거를 통해 추천 서비스에 대한 요청이 포함된 트레이스만 검색하고 필터링할 수 있다.
지연 시간순으로 정렬하면 오래 걸린 특정 트레이스를 빠르게 찾을 수 있다. 오른쪽 패널에서 트레이스를 클릭하면 워터폴 보기를 확인할 수 있다.
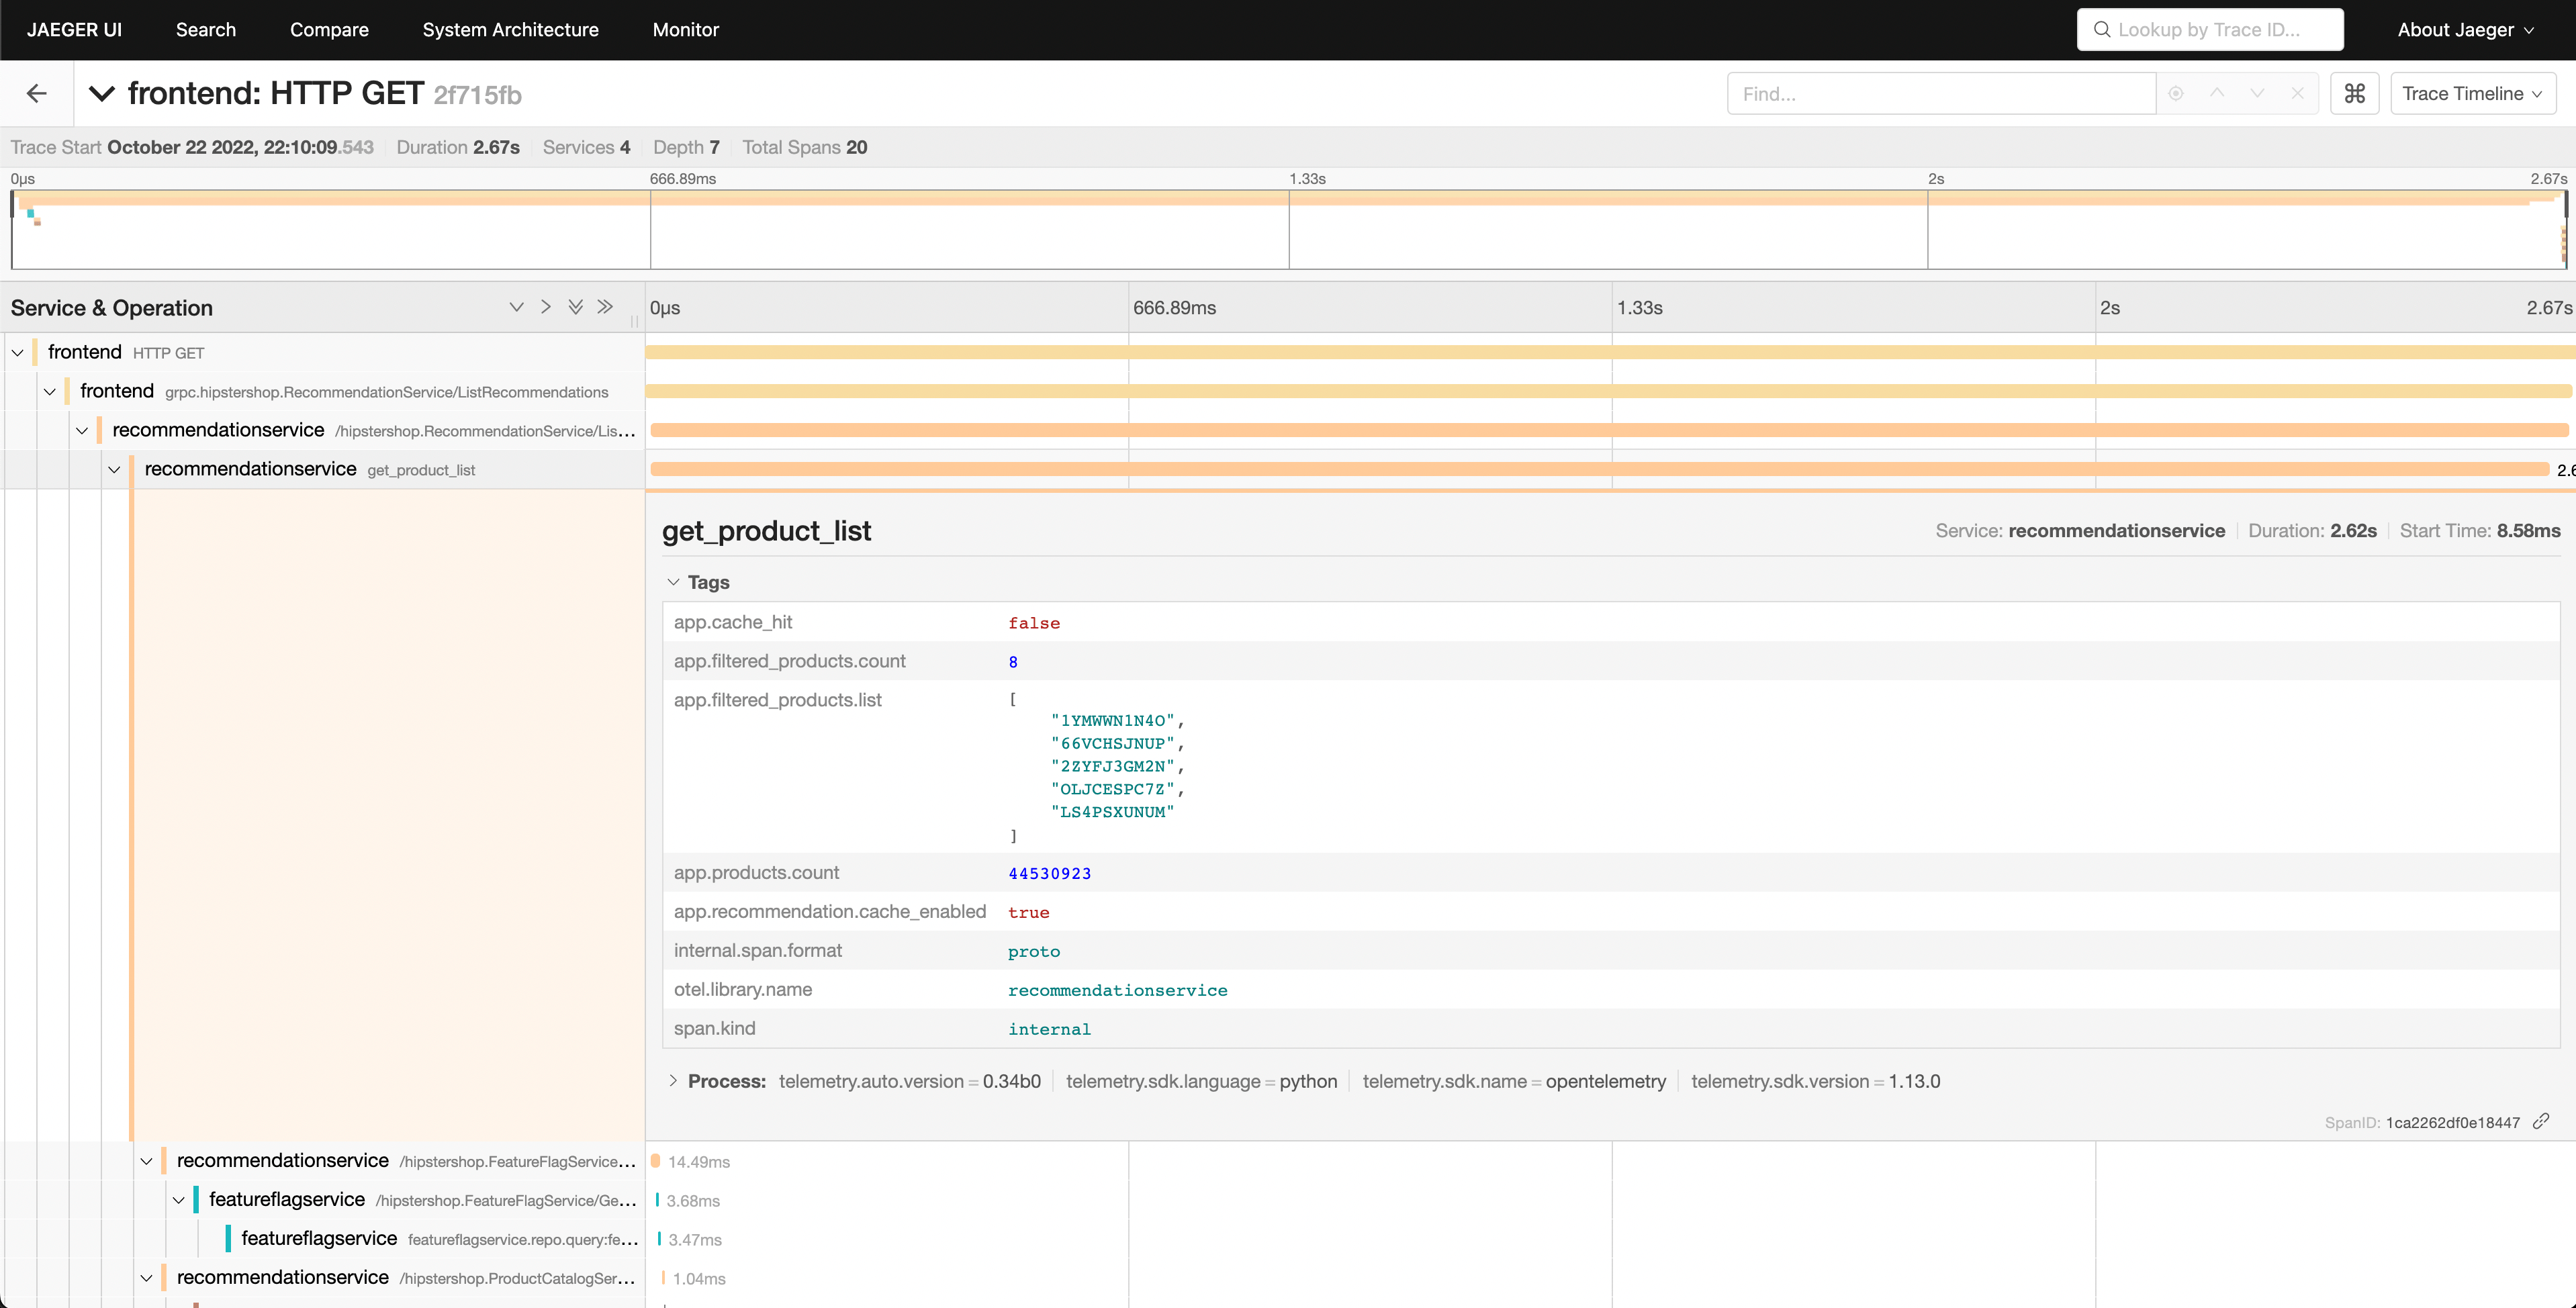
추천 서비스가 작업을 완료하는 데 오랜 시간이 걸리는 것을 확인할 수 있으며, 세부 정보를 살펴보면 어떤 일이 일어나고 있는지 더 잘 파악할 수 있다.
진단 확인
워터폴 보기에서 app.cache_hit 속성이 false로 설정되어 있고,
app.products.count 값이 매우 큰 것을 확인할 수 있다.
검색 UI로 돌아가 Service 드롭다운에서 recommendation을 선택하고, Tags
입력란에서 app.cache_hit=true를 검색한다. 캐시에 적중하면 요청이 더 빠르게
처리되는 경향이 있다는 점에 주목한다. 이제 app.cache_hit=false를 검색하고 지연
시간을 비교한다. 트레이스 목록 상단의 시각화에서 몇 가지 변화를 확인할 수 있다.
이 시나리오는 의도적으로 구성한 것이므로 코드에서 근본적인 버그를 어디서 찾아야 하는지 알고 있다. 하지만 실제 상황에서는 코드에서 어떤 일이 일어나는지, 또는 어떤 서비스 간 상호작용이 문제를 일으키는지 알아내기 위해 추가로 조사해야 할 수 있다.
피드백
이 페이지가 도움이 되었나요?
Thank you. Your feedback is appreciated!
Please let us know how we can improve this page. Your feedback is appreciated!